Petite histoire de l'informatique, du stockage et de l'IA
Le stockage des informations
Informatique
En 1957, l'ingénieur allemand Karl Steinbuch crée le terme « Informatik » pour son essai intitulé Informatik: Automatische Informationsverarbeitung, pouvant être rendu en français par « Informatique : traitement automatique de l'information ».
En 1966, l'Académie française consacre l'usage officiel du mot pour désigner la « science du traitement de l'information ». La presse, l'industrie et le milieu universitaire l'adoptent dès cette époque.
D'après Wikipedia, article « Informatique »
L'informatique est donc, étymologiquement, bien antérieure aux ordinateurs. Il s'agit de savoir comment les informations sont stockées, sur quels supports, et comment elles sont traitées.
Pré-histoire de l'informatique :
Stocker l'information
Les premières traces laissées délibérément et nous étant parvenues par les êtres humains sont les peintures et gravures rupestres. Elles gardent de nombreux mystères, mais sont réellement des chefs-d'œuvre de civilisations passées.
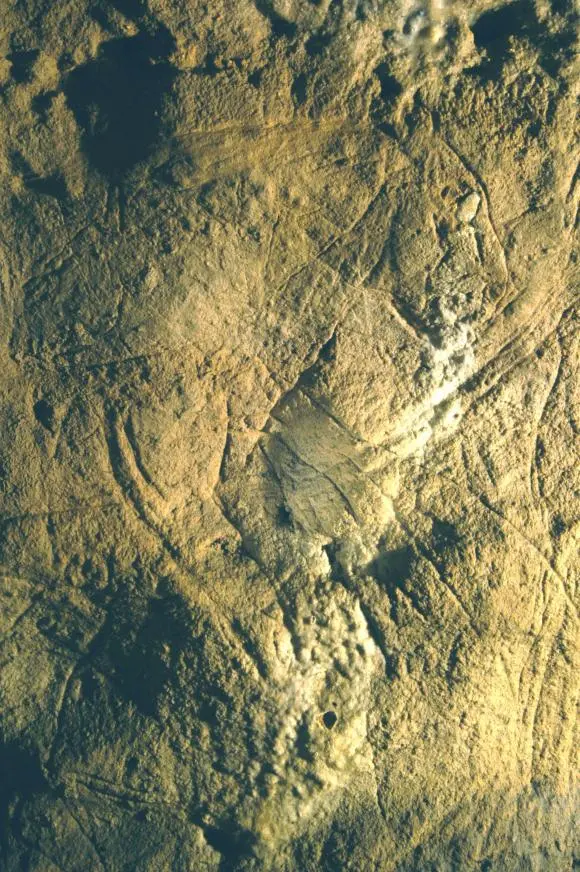
Les archéo-anthropologues s'accordent actuellement sur le fait que des proto-écritures ont été utilisées, mais nous ne disposons actuellement pas de pierres de Rosette permettant de les décrypter.
On trouve ensuite les gravures sur rochers, puis rapidement les tablettes d'argiles, etc.

Ces supports sont particulièrement résistants, mais difficiles à stocker et ne peuvent contenir que peu d'informations. Mais ils étaient utilisés quotidiennement par les scribes, y compris pour l'apprentissage des mathématiques, de la loi, de la médecine, etc.

Les supports de type papyrus, vélins (peau) sont probablement très anciens, mais ils se dégradent facilement, sont sensibles aux incendies, etc. Leurs difficultés de conservation sont cependant contrebalancées par la plus grande facilité à les travailler. Ils deviennent dès l'antiquité le support privilégié pour transmettre et conserver des informations, dans toutes les grandes civilisations. Les techniques de fabrication du papier se développent à partir de la Chine et atteignent l'Europe entre le Xe siècle et le XIVe siècle.


Jusqu'à la fin de l'époque médiévale, la possibilité la plus répandue pour obtenir un manuscrit était de le recopier à la main - d'où la grande importance des moines-copistes et des monastères qui s'y consacraient dans la sphère d'influence occidentale. Cependant, le procédé de xylographie (principe du tampon encreur avec une matrice en bois), ainsi que des procédés simplifiés de fabrication du papier transitent avec la grande horde mongole par l'intermédiaire de la route de la soie. Vers 1430, Johannes Gutenberg invente le principe de la presse à imprimer à caractères mobiles et facilite grandement la copie d'œuvres écrites. Une nouvelle ère de développement de la science et des idées se répand sur l'Europe.

Traiter l'information
Les systèmes de comptages sont limités, du calculi (petits cailloux en latin), aux systèmes de comptages cunéiformes sexagésimaux (en base \(60\)), dont nous avons hérité pour notre décompte des heures et des angles en degré. On trouve rapidement cependant le système des bouliers (ou abaques), découvert de manières indépendantes par de multiples civilisations tout autour du globe.

La machine d'Anticythère, découverte en 1900 et datée de 87 avant J.C. est une machine servant à calculer les positions astronomiques, et donc à naviguer. Elle nous montre que le calcul a toujours été un enjeu capital, et que l'humanité a fait preuve d'une très grande ingéniosité pour améliorer ses capacités de calculs (une très bonne vidéo en anglais est disponible ici).

De l'Antiquité jusqu'au Moyen Âge, les sciences se développent tranquillement, mais sans base mathématique autre que la géométrie. L'arrivée des chiffres dits arabes, qui remplacent les peu efficaces chiffres romains, modifie complètement les manières de faire : les commerçants s'emparent de ces chiffres et des algorithmes de calculs développés par les savants du monde musulman, et on assiste à l'apparition d'une bourgeoisie éduquée et savante qui communique à travers toute l'Europe. L'algèbre et l'arithmétique se développent, mais tous les calculs restent effectués au boulier ou à la main.
Des machines à calculer et des métiers à tisser
Au XVIIe siècle, Blaise Pascal, scientifique et penseur français, invente à 19 ans (en 1642) une machine à calculer pour aider son père à remettre de l'ordre dans les recettes fiscales d'une province française. Cette machine, la pascaline, était capable d'effectuer des opérations élémentaires par l'intermédiaire d'un ingénieux système d'engrenages. Cependant, la précision nécessaire à la réalisation de ces engrenages en a rendu la conception extrêmement couteuse, et peu de machines furent produites.

Gottfried Leibniz est un penseur allemand. Il fait progresser la philosophie, les mathématiques, la physique et l'ingénierie tout autant que son homologue français. Entre 1671 et 1694, il améliore la pascaline en lui ajoutant la possibilité de multiplier, et l'utilise pour le calcul différentiel.
En 1725, Basile Bouchon, un Lyonnais, met au point le premier système de programmation d’un métier à tisser grâce à un ruban perforé. En 1728, Jean-Baptiste Falcon, son assistant, remplace le ruban par une série de cartes perforées reliées entre elles. Jacques de Vaucanson reprend cette idée en remplaçant ruban et cartes perforées par un cylindre métallique et enfin Joseph Marie Jacquard lie le tout dans son métier à tisser qui fut adopté dans le monde entier à partir de 1801.
Ces cartes perforées sont les premiers exemples de supports de stockages permettant de stocker d'autres informations que l'écrit ou l'image. En effet, ces cartes sont utilisées dans les orgues de barbarie pour représenter de la musique, et sur les métiers Jacquard afin d'y représenter des motifs de tissage.
Les métiers à tisser Jacquard sont la pointe de la technologie. Ils utilisent les cartes perforées pour réaliser des motifs complexes et sont donc « programmables » par l'introduction de nouvelles cartes.

Le canard de Vaucanson : un robot
Dans l'histoire des automates, le canard de Vaucanson possède une place privilégiée : à la fois merveilleuse imitation mécanique de la vie mais aussi trucage relevant de la prestidigitation, il est déjà porteur de toutes les interrogations de notre monde contemporain concernant les robots et l'IA. La vidéo d'Arte le concernant est un must à voir absolument !
Les pères et mères de l'informatique
Les machines à calculer

Au XIXe siècle, l'Empire Britannique est à son apogée et sa puissance repose sur sa force navale, aussi bien commerciale que militaire. Or à bord d'un navire la navigation se fait toujours aux étoiles et par l'intermédiaire de cartes marines de plus en plus détaillées. Un navigateur à cette époque utilise quotidiennement des tables de navigations, qui ne sont rien d'autre que des tables de trigonométrie et de logarithmes. Et ces tables sont établies et calculées à la main et sont loin d'être exemptes d'erreurs de calcul. En 1833 - 1834, le mathématicien anglais Charles Babbage imagine une machine utilisant des cartes perforées qui permettrait d'effectuer des calculs scientifiques, la machine analytique (Analytical Engine). Cette machine ne sera jamais opérationnelle du vivant de Babbage.
Ada Lovelace (1815 - 1852), est une mathématicienne anglaise. Travaillant avec Charles Babbage, elle imagine pouvoir faire jouer de la musique, afficher des chiffres et des lettres avec la machine analytique. Elle décrit, plus d'un siècle avant son invention, l'ordinateur : « La machine analytique n'a nullement la prétention de créer quelque chose par elle-même. Elle peut exécuter tout ce que nous saurons lui ordonner d'exécuter. Elle peut suivre une analyse ; mais elle n'a pas la faculté d'imaginer des relations analytiques ou des vérités. Son rôle est de nous aider à effectuer ce que nous savons déjà dominer. »

Vers 1842 elle écrit des algorithmes pour réaliser un programme informatique et toutes les instructions à donner à la machine, jusqu'aux positions des rouages. Elle invente les concepts de boucle et de branchements conditionnels et devient ainsi la première programmeuse.
L'apparition de l'électricité comme source d'énergie va rapidement permettre le développement de moteurs qui améliorent les machines à calculer. À la fin du XIXe siècle, Herman Hollerith conçoit une machine utilisant des cartes perforées qui permet de simplifier le recensement de la population aux États-Unis (1890). Il fonde une société qui prendra rapidement le nom d'IBM. Les machines à calculer électromagnétiques se développent rapidement, et en parallèle les mathématiques progressent à grand pas.
Mathématicien et cryptologue britannique (1912-1954), Alan Turing a d'abord travaillé sur l'idée de calculabilité. Il montre que ce qui est calculable peut se décomposer en un nombre fini d'étapes et peut de ce fait être réalisé par une machine. Il imagine à la fin des années 1930 un calculateur (appelé «Machine de Turing», voir plus loin), mais celui-ci ne sera construit que 20 ans plus tard. Il imagine le moyen pour une machine de reproduire certaines actions humaines, et développe par une expérience de pensée un procédé appelé aujourd'hui « Test de Turing» permettant de savoir si une intelligence artificielle est capable de convaincre un humain qu'elle est humaine.

Lors de la Seconde Guerre mondiale, Alan Turing coordonne l'équipe chargée du décodage de la machine Enigma utilisée par les nazis. Il construit une machine, surnommée « La bombe », qui permet le déchiffrement rapide des messages allemands. Cette machine électromécanique n'est pas un ordinateur : elle est conçue pour une seule tâche, et il faut la re-câbler pour en changer.

De l'électronique à la micro-informatique
L'électronique nait de l'invention des tubes à vide au début du XXe siècle. La machine Colossus, créée entre 1943 et 1945 (mais dont l'existence ne fut révélée qu'en 1970) utilise ces tubes à vide.

L'ENIAC, construit de 1943 à 1945, naît d'une idée de John William Mauchly, aidé pour la résolution des problèmes d'ingénierie par J. Presper Eckert. Il sert à calculer des trajectoires balistiques et est financé par l'armée américaine, pour un coût important, les tubes à vide ayant une durée de vie très limitée. L'ENIAC est surtout connu pour son côté colossal : 30 tonnes, \(167 ~m^2\) de surface au sol.

Il est d'un grand secours pour les calculs balistiques, qui sont fastidieux. Par exemple voici le temps de calcul pour une table de tir :
| Moyen | Temps |
|---|---|
| À la main | 2,6 j |
| Avec une machine à calculer | 12 h |
| Model 5 (concurrent de l'ENIAC) | 40 min |
| ENIAC | 3 s |
| PC moderne | <30 µs |
Entre \(1944\) et \(1955\), six femmes, Kathleen Antonelli, Jean Bartik, Betty Holberton, Marlyn Meltzer, Frances Spence et Ruth Teitelbaum sont les premières personnes à programmer l'ENIAC, pour un calcul balistique. Elles sont toutes mathématiciennes. Kathleen Antonelli et Frances Spence sont recrutées en 1942 par l’armée américaine pour calculer manuellement les trajectoires de tir. Marlyn Meltzer et Ruth Teitelbaum sont également calculatrices. Elles travaillent sur l'ENIAC à partir de 1944. Il s'agit d'identifier les différentes étapes du calcul et ensuite de câbler physiquement la machine. Ruth Teitelbaum, Frances Spence et Kathleen Antonelli poursuivirent leur travail sur l’Eniac lorsque celui-ci est transféré à Aberdeen en 1947.
Le transistor est inventé en \(1947\), et il remplace rapidement les tubes à vide à partir du milieu des années \(1950\), le cout de fabrication d'un transistor commençant à être plus faible que celui d'un tube à vide.
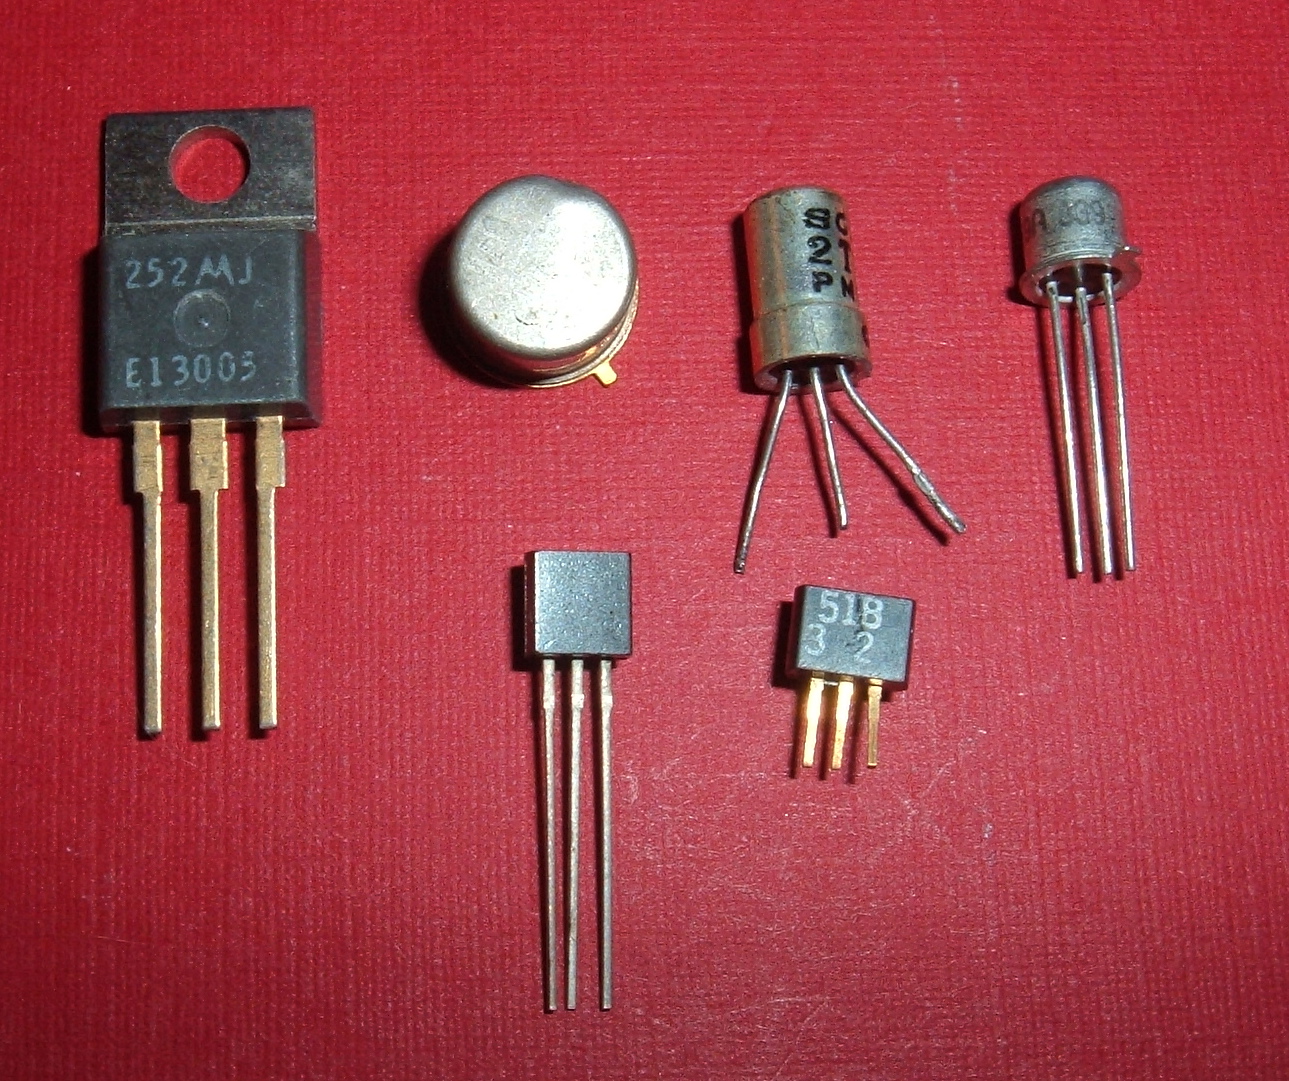
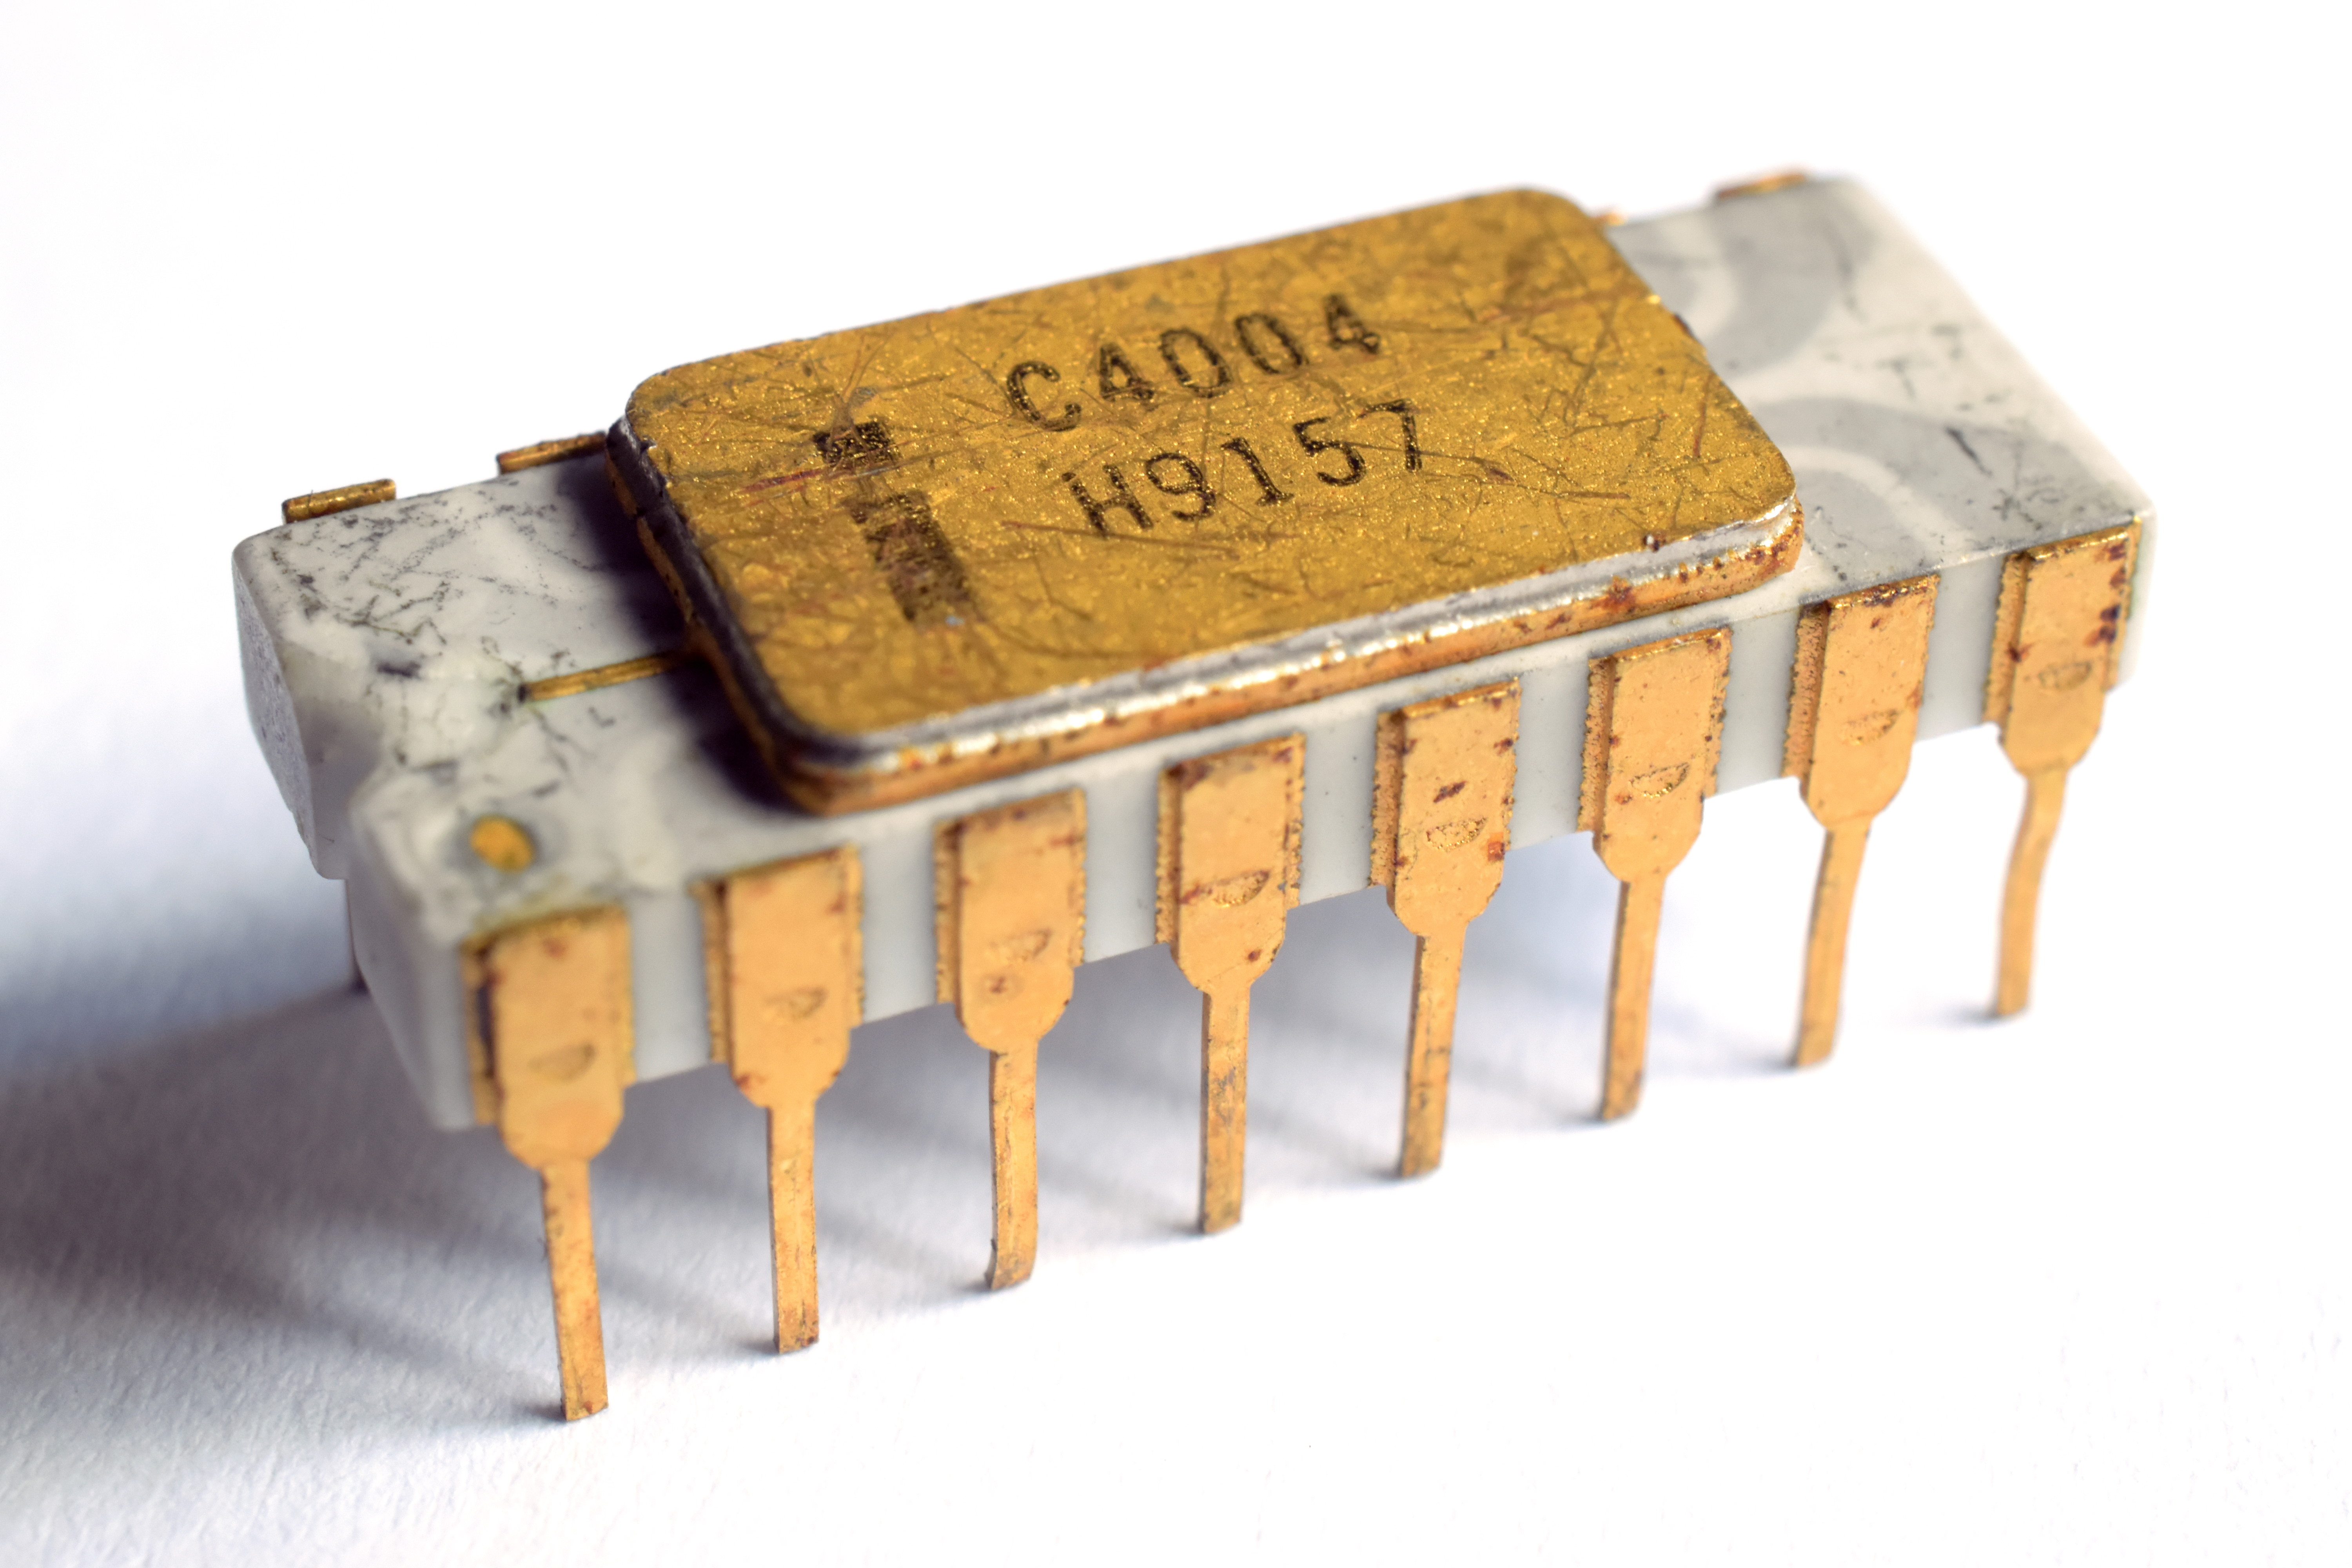
Dès \(1958\) apparaissent les premiers circuits intégrés, et en \(1971\) le premier microprocesseur commercial voit le jour : c'est l'Intel 4004. Les machines sont désormais miniaturisées, fiables et leur cout de fabrication décroit fortement. L'informatique s'ouvre aux particuliers.
De multiples machines sont commercialisées : l’Altair 8800 (1975), l’Apple II (1977), l’IBM PC (1981), le ZX 81 (1981), le commodore 64 (1982), le Macintosh (1984) ... Le ZX 81 est considéré à son époque comme le premier ordinateur familial en kit en France, sa résolution et sa capacité mémoire (1 ko) ne permettait pas énormément de prouesses au niveau des jeux.
De nombreuses sociétés se lancent dans la production de machines familiales à partir du début des années \(1980\), et l'informatique rentre à l'école et commence à y être enseignée, en particulier sur les machines Thomson en France, comme le TO7, le MO5...
Les consoles de jeu
Si les consoles de jeu sont présentes depuis le début des années 1970 - la console Odyssey est la première console à pouvoir être branchée sur l'écran de la télévision dès 1972, les jeux vidéos restent souvent cantonnés dans les salles d'arcades, où les bornes fleurissent à côté des flippers et billards.
À la fin des années 1970 et au début des années 1980, le marché des consoles de jeu est florissant, avec pas moins de 744 modèles différents de consoles rien que pour l'année 1977, dont certaines telles l'Atari 2600, la console Vectrex ou bien la console Videopac ont un certain succès en France.

Le krach du jeu vidéo de 1983 mènera à une forte réduction du nombre d'acteurs sur le marché des consoles, jusqu'à l'arrivée en 1986 de la console Nintendo NES qui bat tous les records de ventes.

Le Stockage numérique des informations
Unités d'informations
Bit
Le bit est l'unité d'information la plus simple dans un système de numération, ne pouvant prendre que deux valeurs, représentées par les chiffres 0 et 1. Un bit peut aussi bien représenter une alternative logique (Vrai et Faux), qu'un chiffre binaire, ou qu'une autre information ne pouvant prendre que deux états (par ex. Ouvert ou fermé).
En théorie de l'information de Shannon, le bit est la quantité minimale d'information pouvant être transmise par un message, et constitue à ce titre l'unité de mesure de base de l'information en informatique.
Un ensemble ordonné de bits permet donc de représenter des informations.
Par exemple :
-
avec 1 bit, on peut stocker une information prenant deux états :
Noir Blanc 0 1 -
avec 2 bits, on peut stocker une information prenant 4 états :
Nord Sud Est Ouest 00 01 10 11 -
avec 3 bits, on peut stocker une information prenant 8 états :
Nord Nord-Est Est Sud-Est Sud Sud-Ouest Ouest Nord-Ouest 000 001 010 011 100 101 110 111
Questions I
- Combien d'états différents peuvent être représentés par ? 4 bits ? 8 bits ? 10 bits ?
- Quel est le nombre minimal de bits nécessaire pour représenter l'alphabet latin en majuscule, sans accents et autres signes diacritiques ?
- Combien de bits sont nécessaires pour représenter tous les caractères de l'alphabet français, en y incluant les signes de ponctuations et les chiffres ?
Octets
Un octet est un mot binaire de 8 bits, et permet de représenter \(256\) informations différentes. Il est devenu l'unité standard de mémorisation des mémoires informatiques. Son symbole dans le système international est o, et ses multiples sont :
| nom | symbole | valeur |
|---|---|---|
| kilooctet | ko | \(10^3\)o |
| mégaoctet | Mo | \(10^6\)o |
| gigaoctet | Go | \(10^9\)o |
| téraoctet | To | \(10^{12}\)o |
| pétaoctet | Po | \(10^{15}\)o |
| exaoctet | Eo | \(10^{18}\)o |
Les stockages de données
Un des premiers systèmes de stockage de masse utilisé est la carte perforée. En 1884, Herman Hollerith dépose un brevet pour une machine électromécanique utilisant des cartes perforées permettant d'accélérer le recensement de la population du gouvernement américain. Il lance par la suite une société qui deviendra IBM.
Une carte perforée est un support d'informations exprimées sous la forme binaire : une grille de « cases » est représentée, cases qui peuvent être perforées (1) ou non (0).
Par exemple la carte ci-dessous, modèle standard d'IBM breveté en 1928, possède 80 colonnes et 12 lignes (les lignes numérotées de 0 à 9, plus deux lignes supérieures non numérotées) permettant techniquement d'encoder un mot de 12 bits (mais en pratique seulement 9 bits étaient utilisés, les lignes numérotées 0 à 8, la ligne 9 servant de « bit de contrôle », et les deux lignes supérieures indiquant des opérations spéciales).

Ces cartes étaient stockées par boites de 2 000, et le coin tronqué servait de repère pour les insérer dans le bon sens dans un chargeur de cartes ou pour les remettre à l'endroit quand la boite tombait par terre.
Standardisation
Si au départ chaque constructeur de machines lectrices de cartes perforées utilisait ses propres cartes, il est devenu assez vite clair qu'une standardisation devait être nécessaire. Cette standardisation est entrée en collision avec la standardisation des bus de données, c'est-à-dire des tailles des mots acceptés par les processeurs (en anglais bytes). Au départ les machines pouvaient accepter des bytes de 5, 6, 7, 8 ou même 9 bits, mais le procédé de standardisation a amené a une généralisation de l'octet comme unité de base.
Sur les cartes perforées IBM, on utilisait alors les lignes numérotées de 0 à 7 pour représenter un octet, le numéro de ligne donnant le poids de chaque bit. Par exemple l'octet 1100 0001 aurait consisté en une colonne trouée en ligne 0, 6 et 7.
Une carte perforée pouvait donc contenir 80 octets, une boite de 2000 cartes perforées contenait 160 ko.
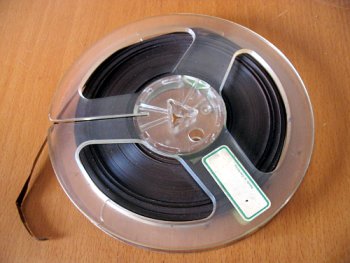
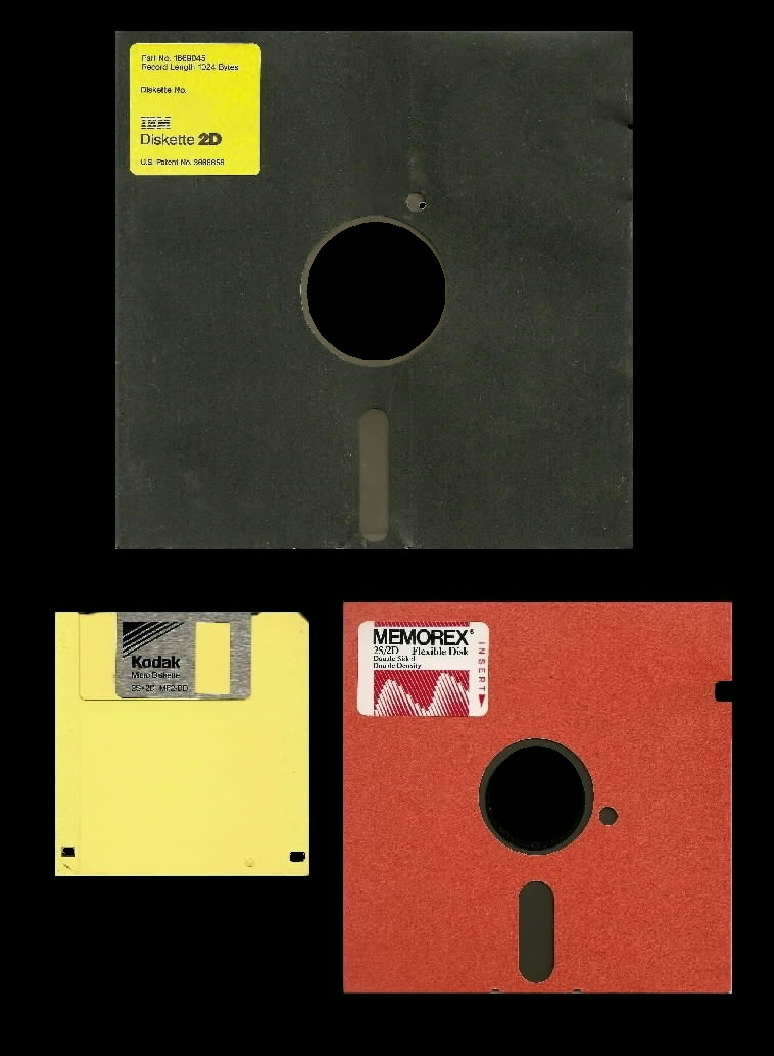
La deuxième génération de support de stockages est constituée par les supports magnétiques. D’abord utilisés sous forme de bandes magnétiques à partir de 1928, ils se sont ensuite miniaturisés et démocratisés sous forme de disques durs à partir des années 1950 puis de cassettes et de disquettes dans les années 1960.
| Bande magnétique | Cassette | Disquettes |
|---|---|---|
 |
 |
 |
La quantité d'information pouvant être contenue dans ces supports croit exponentiellement :
| Année de sortie | Type | Stockage |
|---|---|---|
| 1928 | Bande magnétique | 50 octets par cm |
| 1967 | Disquette 8’ | environ 82 ko |
| 1981 | Disquette 5’1⁄4 | environ 369 ko |
| 1984 | Disquette 5’1⁄4 (2nde génération) | environ 1,2 Mo |
| 1987 | Disquette 3’1⁄2 | environ 1,47 Mo |
Questions II
- Combien de cartes perforées standards sont-elles nécessaires pour contenir autant d'information qu'une disquette 3’1⁄2 de 1987 ?
- Quelle est la longueur de bande magnétique nécessaire pour contenir autant d'information qu'un disquette 3’1⁄2 de 1987 ?
La troisième génération est constituée par les supports optiques. Parmi ceux-ci, on trouve le disque compact (CD) développé au début des années 1980, le DVD apparu au milieu des années 1990 et le Blu-Ray commercialisé à partir du milieu des années 2000. La quatrième génération, enfin, est constituée par les mémoires flash. Cette technologie développée à la fin des années 1980 est au début couteuse et peu efficace pour le stockage. Elle va cependant être améliorée pour devenir le mode standard de nos jours avec les clés USB, les cartes SD et micro SD et les disques SSD.

La quantité d'information pouvant être contenue dans ces supports continue à croitre exponentiellement :
| Année de sortie | Type | Stockage |
|---|---|---|
| 1990 | CD-ROM | environ 682 Mo |
| 1995 | DVD | entre 4,7 et 17 Go |
| 2000 | Mémoire flash | 16 Go |
| 2007 | SSD | 1 To |
| 2013 | SSD | 6 To |
| 2015 | SSD | 10 To |
| 2019 | SSD | 16 To |
| 2026 | SSD | 512 To |
Questions III
- Combien de cartes perforées standards sont-elles nécessaires pour contenir autant d'information qu'un DVD de 4,7 Go ?
- Sachant qu'une carte mesure 17/100 de mm d'épaisseur, quelle serait l'épaisseur du paquet de carte nécessaire pour contenir autant de données qu'un DVD de 4,7 Go ?
Se représenter les volumes d'informations
Le texte
Norme ASCII
L'American Standard Code for Information Interchange est une norme d'encodage de caractères, construite d'abord sur 7 bits puis étendue par la suite sur 1 octet.

Dans cette table le caractère A est représenté par l'octet 0100 0001.
L'Unicode
Avec la démocratisation d'internet, de nombreux standards différents sont apparus pour gérer toutes les langues et tous les alphabets. Le problème : la même séquence de bits représentait différents caractères selon les alphabets, les langues, etc.
La norme Unicode a été développée pour répondre à ce problème, et englober l'intégralité des signes possibles.
Le code UTF-8 est l'implémentation de la norme Unicode aujourd'hui la plus utilisée. En unicode, un caractère est codé sur 1, 2, 3 ou 4 octets. «La principale caractéristique d'UTF-8 est qu'elle est rétro-compatible avec le standard ASCII, c'est-à-dire que tout caractère ASCII se code en UTF-8 sous forme d'un unique octet, identique au code ASCII. Par exemple « A » (A majuscule) a pour code ASCII 65 (0x41) et se code en UTF-8 par l'octet 65. Chaque caractère dont le point de code est supérieur à 127 (0x7F) (caractère non ASCII) se code sur 2 à 4 octets. Le caractère « € » (euro) se code par exemple sur 3 octets : 226, 130, et 172 (0xE2, 0x82 et 0xAC).»2
Questions IV
En supposant que tous les caractères utilisés soient codés sur 1 octet :
- Quelle est la taille en ko d'une page de 1 000 caractères ?
- Quelle est la taille en Mo d'un livre de 1 000 pages ?
- Quelle est la taille en Go d'une bibliothèque de 1000 livres ?
- Un volume de l'Encyclopedia Britannica contient 8 millions de caractères. Quelle serait sa taille en octet (sans les images) ?
- À votre avis, quelle est la taille de Wikipedia en Anglais, sans les images ?3
Les images
Codage des images matricielles sans compression
Une image est définie par sa taille en pixel, puis par un certain nombre de facteurs :
- un pixel d'une image en noir et blanc pur (pas de niveau de gris) correspond à 1 bit (0 pour noir, 1 pour blanc) ;
- un pixel d'une image en nuance de gris correspond à 1 octet (valeurs de 0 (Noir) à 255 (Blanc)) ;
- un pixel d'une image en couleur RGB utilise trois octets (1 pour la nuance de rouge, un pour la nuance de vert, un pour la nuance de bleu) ;
- un pixel d'une image en couleur RGBA, c'est-à-dire avec transparence, utilise 4 octets.
Questions V
- Sur la console Vectrex4, sortie en 1982, l'écran monochrome noir et blanc offrait une résolution de 360x480 pixels. Quelle était la taille en octets d'une image sur cet écran ?
- Sur la console NES5, sortie en 1986, la résolution était de 256x240 pixels, mais 52 couleurs étaient possibles, codées sur 1 octet (pour simplifier). Quelle était la taille en octet d'une image ?
- Combien de nuances de couleurs sont disponibles pour un appareil utilisant un codage RGB ?
- En 2007, le Nokia N95 possède une optique photo en 5 Mégapixels en mode RGB. Quelle était la taille en octets d'une photo ?
- La résolution d'un écran d'ordinateur actuel est souvent de 1920x1080 pixels (Full HD). Quel est le poids en octet d'un fond d'écran en mode RGBA ? À combien de livres de la partie précédente cela revient-il ?
La vidéo
Une vidéo, ce n'est rien de plus que des images qui se succèdent à une certaine cadence, un nombre d'images par seconde, où FPS (Frame per second).
Questions VI
- Quel est le poids d'une vidéo non-compressée d'une minute en Full HD en mode RGB avec 25 images par secondes ?
- Un DVD contient au maximum 8.5 Go en double-couche. Quelle durée de film en Full HD/RGB peut-il supporter théoriquement ?
- En 4K, la résolution est de 3840x2160 pixels en RGB. Le film «le Hobbit : La bataille des cinq armées» dure 164 minutes en version longue. Quelle quantité théorique d'information faut-il pour contenir ce film ?
- Quelle quantité d'octets serait théoriquement nécessaire pour jouer 30 minutes sur un jeu en 60 FPS avec une résolution Full HD ?
- J'ai scrollé 1h30 aujourd'hui sur TikTok, en regardant des vidéos FullHD RGB en 25 images par secondes. Combien de livres aurais-je pu télécharger avec la même consommation ?
Compression de données
Bien entendu tout ceci est théorique, puisque des algorithmes de compression de données sont utilisés en permanence pour ce qui est du texte, des images ou des vidéos.
Par exemple, le format png est en fait issu d'un algorithme de compression de données sans pertes (on peut retrouver toutes les informations de l'image originale). Le format jpg est un format de compression avec pertes, donc donnant un résultat utilisant moins de ressources, mais qui a le défaut de ne pas permettre d’obtenir toutes les informations de l'image originale.
Pour ce qui est de la vidéo, l'importance de la compression est phénoménale à l'heure actuelle, et des entreprises mènent une guerre de brevet dans ce domaine (voir l'excellente vidéo de la chaine _UNDERSCORE avec J.B. Kempf de VLC ).
Petite histoire de l'intelligence artificielle
Les débuts
En 1950, Alan Turing se demande si une machine peut « penser » et propose le test qui porte son nom. Le terme intelligence artificielle (IA) apparait en 1956, lors d'un séminaire d'été organisé au Dartmouth College (États-Unis) par John McCarthy, Marvin Minsky, Claude Shannon et Nathaniel Rochester.
Intelligence artificielle
Une intelligence artificielle est un programme informatique capable de réaliser des tâches que l'on associe habituellement à l'intelligence humaine : reconnaitre une image, comprendre une phrase, jouer aux échecs, prendre une décision...
Deux grandes approches se distinguent dès l'origine :
- l'approche symbolique : un humain écrit des règles que la machine applique (systèmes experts) ;
- l'approche par apprentissage : la machine déduit elle-même des règles à partir d'exemples. C'est cette approche qui domine aujourd'hui.
Dès 1957-1958, Frank Rosenblatt construit le perceptron, un des premiers modèles de neurone artificiel capable d'apprendre. Son principe : le neurone additionne ses signaux d'entrée, chacun multiplié par un poids, puis produit une sortie (par exemple 0 ou 1) selon que cette somme dépasse un seuil. Apprendre, c'est ajuster les poids pour que la sortie soit la bonne.

Les résultats sont cependant limités par la faible puissance des machines et le manque de données : l'enthousiasme retombe, et l'IA traverse deux périodes de désintérêt et de baisse des financements, appelées les « hivers de l'IA » (années 1970, puis fin des années 1980). En 1997, l'ordinateur Deep Blue d'IBM bat le champion du monde d'échecs Garry Kasparov, mais en s'appuyant surtout sur une puissance de calcul énorme et des règles écrites par des humains.
L'apprentissage supervisé
Apprentissage supervisé
Dans l'apprentissage supervisé, on fournit à la machine un grand nombre d'exemples étiquetés (une entrée et la bonne réponse attendue). Elle ajuste ses paramètres pour se tromper le moins possible, puis on la teste sur des exemples qu'elle n'a jamais vus.
Il existe deux grandes familles de problèmes supervisés : la régression et la classification.
La régression
La régression consiste à trouver une fonction qui explique une grandeur à partir d'une ou plusieurs autres, afin de prédire une valeur numérique (prix d'un logement, température de demain, consommation électrique...).
L'idée est ancienne : la méthode des moindres carrés est publiée par Legendre en 1805 et utilisée par Gauss, notamment pour prédire la position d'un astéroïde. Le mot « régression » est introduit par Francis Galton à la fin du XIXe siècle.
Dans le cas le plus simple, la régression linéaire, on cherche la droite \(y = ax + b\) qui passe « au plus près » d'un nuage de points, c'est-à-dire qui minimise l'écart entre les valeurs prédites et les valeurs réellement observées. Les paramètres \(a\) et \(b\) sont ajustés à partir des données : c'est déjà un exemple d'apprentissage.
La classification
Il s'agit cette fois de ranger une donnée dans une catégorie : message « spam » ou « non spam », photo de chat ou de chien, tumeur bénigne ou maligne...
Les réseaux de neurones artificiels, qui assemblent de nombreux perceptrons en plusieurs couches et sont inspirés (très librement) du fonctionnement du cerveau, sont l'outil le plus répandu. Plusieurs étapes marquent leur histoire :
- 1986 : popularisation de l'algorithme de rétropropagation, qui permet d'entrainer des réseaux à plusieurs couches ;
- années 1990 : Yann LeCun utilise des réseaux de neurones pour lire automatiquement les chiffres manuscrits des chèques ;

- 2012 : le réseau AlexNet écrase la concurrence au concours de reconnaissance d'images ImageNet. C'est le début de l'ère de l'apprentissage profond (deep learning), rendu possible par de très grandes bases de données et par les cartes graphiques (GPU).
Le rôle des humains
L'apprentissage supervisé suppose que des humains aient étiqueté les données, souvent en grand nombre et à bas cout. La qualité de l'IA dépend donc directement de la qualité et de la représentativité de ces données : si elles sont biaisées, l'IA reproduira ces biais.
L'apprentissage non supervisé
Apprentissage non supervisé
Dans l'apprentissage non supervisé, les données ne sont pas étiquetées. La machine doit découvrir seule des structures cachées : groupes d'éléments semblables, régularités, anomalies.
Une application classique est le partitionnement (clustering) : regrouper des clients aux comportements proches, des articles de presse traitant du même sujet ou des gènes ayant des fonctions voisines, sans avoir défini les groupes à l'avance. L'algorithme des k-moyennes (k-means) en est l'exemple le plus connu. On l'utilise aussi pour les systèmes de recommandation ou la détection de fraudes.
On parle également d'apprentissage par renforcement : la machine apprend par essais et erreurs en recevant des récompenses. C'est ainsi que le programme AlphaGo (Google DeepMind) a battu en 2016 le champion du monde de go Lee Sedol, un jeu bien trop complexe pour une approche par force brute.
| Régression | Classification | Non supervisé | |
|---|---|---|---|
| Données étiquetées | oui | oui | non |
| Objectif | prédire une valeur | prédire une catégorie | trouver des groupes ou des structures |
| Exemple | prix d'un appartement | spam / non spam | regrouper des clients |
Les grands modèles de langage (LLM)
En 2017, des chercheurs de Google publient l'article Attention is all you need qui présente l'architecture Transformer. Elle permet d'entrainer de très grands réseaux de neurones sur d'énormes quantités de textes, en parallèle sur de nombreux processeurs.
LLM
Un grand modèle de langage (Large Language Model, LLM) est un réseau de neurones entrainé sur une très grande quantité de textes (livres, sites web, code informatique...) pour prédire le mot suivant (plus précisément le jeton ou token) d'une séquence.
Transformer
Un transformer est une architecture de réseau de neurones fondée sur le mécanisme d'attention : pour comprendre chaque mot (ou jeton), le modèle évalue l'importance de tous les autres mots du contexte. Dans la phrase « Le chat a mangé la souris parce qu'il avait faim », l'attention permet de relier « il » au bon mot.
Contrairement aux modèles précédents, qui lisaient le texte mot après mot, un transformer traite tous les jetons en parallèle. On peut donc l'entrainer sur d'énormes quantités de textes avec des milliers de processeurs.
Cet entrainement est dit auto-supervisé : il n'y a pas besoin d'étiqueter les données, puisque le texte lui-même fournit la réponse attendue (le mot qui suit). Le modèle est ensuite affiné avec l'aide d'évaluateurs humains pour que ses réponses soient utiles et acceptables.
Quelques repères :
| Année | Évènement |
|---|---|
| 2017 | Architecture Transformer |
| 2018 | Premiers modèles GPT (OpenAI) et BERT (Google) |
| 2020 | GPT-3, avec 175 milliards de paramètres |
| novembre 2022 | Lancement de ChatGPT, qui atteint plus de 100 millions d'utilisateurs en quelques mois |
| depuis 2023 | Multiplication des modèles (Claude, Gemini, Llama, Mistral...) capables aussi de traiter images, sons et code |
Les limites des LLM
Un LLM ne comprend pas au sens humain : il produit le texte le plus probable. Il peut donc :
- produire des affirmations fausses mais convaincantes (on parle d'hallucinations) ;
- reproduire les biais présents dans ses données d'entrainement ;
- poser des questions de droits d'auteur et de protection des données personnelles ;
- avoir un fort cout énergétique (entrainement et utilisation).
Il faut donc toujours vérifier les informations, croiser les sources et garder son esprit critique.
Questions VII
- Citer un exemple de problème relevant de la régression, un de la classification et un de l'apprentissage non supervisé.
- Pourquoi dit-on qu'un apprentissage est « supervisé » ? Quelle est la contrepartie de cette supervision ?
- Pourquoi l'apprentissage profond n'a-t-il décollé qu'à partir des années 2010, alors que les réseaux de neurones existent depuis les années 1950 ?
- Expliquer en une phrase comment un LLM génère une réponse. Pourquoi peut-il se tromper avec aplomb ?
- Citer deux précautions à prendre lorsqu'on utilise un LLM pour préparer un exposé.
-
Image Wikipedia, crédit :« Par Arnold Reinhold — I took this picture of an artifact in my possession. The card was created in the late 1960s or early 1970s and has no copyright notice., CC BY-SA 2.5, https://commons.wikimedia.org/w/index.php?curid=775153 » ↩